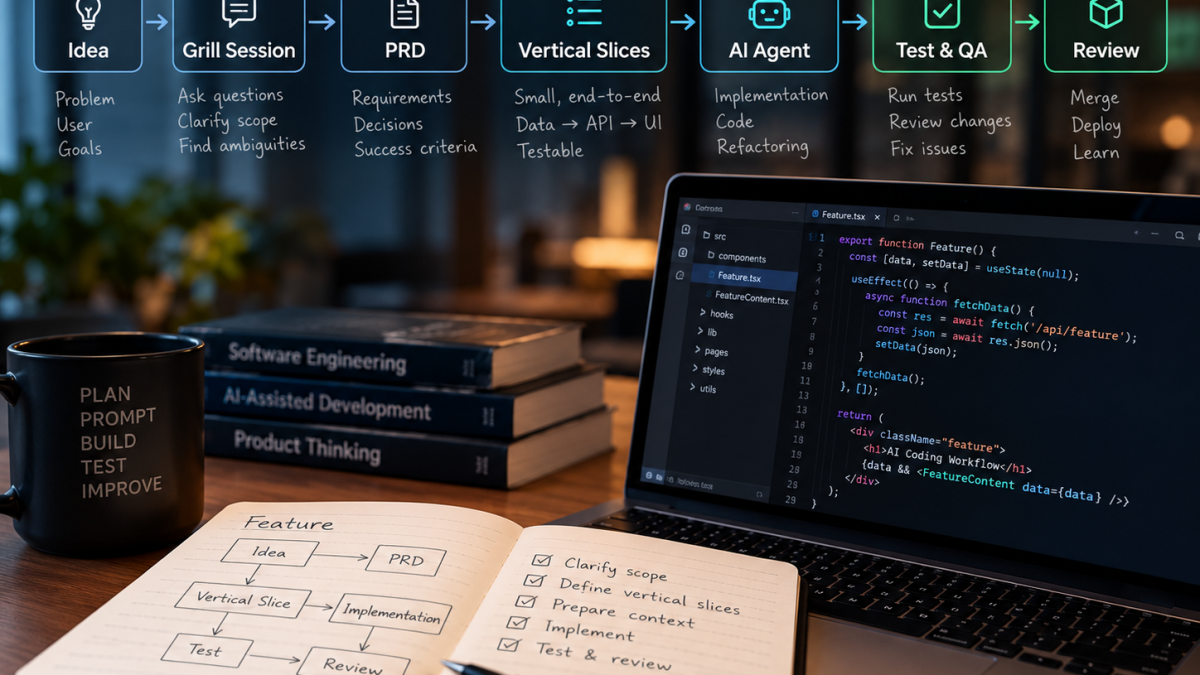
مدتی است تقریباً هر بحثی درباره برنامهنویسی با هوش مصنوعی به چند سؤال تکراری میرسد:
کدام مدل بهتر کد میزند؟ چه پرامپتی بنویسیم؟ Claude بهتر است یا Codex؟ از Agent استفاده کنیم یا همان Chat کافی است؟
اما بعد از دیدن ویدئوی Matt Pocock با عنوان Full Walkthrough: Workflow for AI Coding، به نظرم سؤال مهمتر چیز دیگری است:
آیا اصلاً فرایند توسعهمان برای کار با AI درست طراحی شده است؟
این ویدئو بیشتر از آنکه درباره یک مدل یا ابزار خاص باشد، درباره طراحی یک Workflow مهندسی برای AI Coding است؛ فرایندی که از یک ایده مبهم شروع میشود و تا پیادهسازی، تست، بازبینی و تحویل Feature ادامه پیدا میکند. صفحه بازنشر ویدئو
مسئله اصلی، تولید کد نیست
AI همین حالا هم میتواند کد زیادی تولید کند.
اما تولید کد الزاماً همان حل مسئله نیست.
در یک پروژه واقعی، قبل از اینکه اولین خط کد نوشته شود، باید بفهمیم دقیقاً چه چیزی قرار است ساخته شود، چه محدودیتهایی داریم، چه بخشهایی به هم وابستهاند و چه چیزی را «تمامشده» در نظر میگیریم.
اگر یک نیاز مبهم را مستقیم به Agent بدهیم، احتمالاً چیزی تحویل میگیریم که از نظر ظاهری قابل قبول است، اما ممکن است مسئله واقعی را حل نکند.
یکی از ایدههای اصلی Workflow پیشنهادی Matt همین است: قبل از Implementation، ابهام را کاهش بده.
مسیر کلی چیزی شبیه این است:
Idea → Research / Prototype → Grill Session → PRD → Issues → Implementation → QA
بعضی مراحل مثل تحقیق و Prototype اختیاریاند، اما بخش مهم این است که Agent نباید مستقیماً از «یک ایده خام» به «نوشتن کد» بپرد. صفحه بازنشر ویدئو
Grill Session: قبل از کدنویسی، مسئله را بازجویی کن
یکی از جالبترین بخشهای این Workflow چیزی است که Matt آن را Grill Session مینامد.
بهجای اینکه به AI بگوییم:
این Feature را برای من بساز.
AI باید شروع به سؤال پرسیدن کند.
هدف این سؤالها این نیست که صرفاً یک Prompt طولانیتر تولید شود. هدف این است که ابهامهای محصول و معماری قبل از Implementation آشکار شوند.
مثلاً:
- این Feature دقیقاً برای چه کسی است؟
- چه رفتارهایی باید پشتیبانی شوند؟
- چه چیزی خارج از Scope است؟
- چه Edge Caseهایی داریم؟
- چه بخشهایی از سیستم موجود باید تغییر کند؟
- چه تصمیمهایی هنوز گرفته نشدهاند؟
میتوان این مرحله را راهی برای ایجاد Shared Understanding بین انسان و Agent دانست. بعد از اینکه این فهم مشترک شکل گرفت، خروجی آن میتواند به یک PRD تبدیل شود. Alexana Learning Library
به نظرم اینجا یک نکته مهم وجود دارد:
کیفیت AI Coding از کیفیت تعریف مسئله شروع میشود، نه از کیفیت کدنویسی مدل.
PRD مقصد است، نه چیزی مقدس
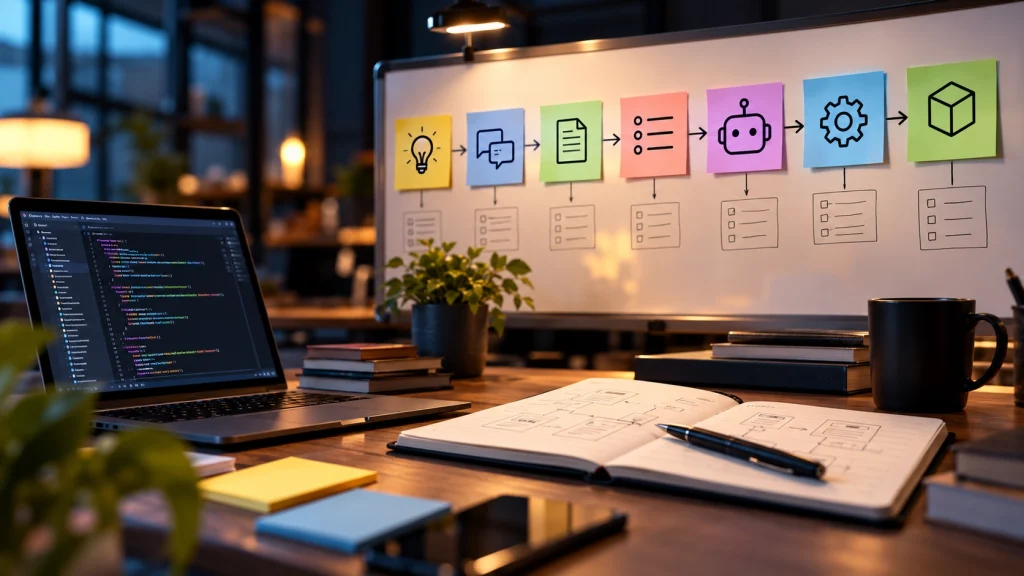
بعد از مرحله پرسشوپاسخ، یک PRD تهیه میشود.
اما نکته جالب این است که در این Workflow، PRD قرار نیست تبدیل به یک سند عظیم و بینقص شود.
نقش آن بیشتر شبیه یک Destination Document است؛ سندی که مشخص میکند قرار است به کجا برسیم.
تمرکز اصلی همچنان روی فهم مشترک و تصمیمهایی است که در Grill Session گرفته شدهاند، نه روی اینکه دهها صفحه Specification تولید کنیم. Alexana Learning Library
این نگاه برای من جالب بود، چون یکی از وسوسههای کار با AI این است که حجم زیادی Document تولید کنیم و احساس کنیم چون مستندسازی بیشتری داریم، مسئله هم بهتر فهمیده شده است.
در حالی که ممکن است فقط متن بیشتری تولید کرده باشیم.
پروژه بزرگ را به Vertical Slice تبدیل کن
یکی از بخشهای مهم ویدئو درباره نحوه شکستن Featureهاست.
در بعضی برنامهریزیهای تولیدشده با AI، پروژه بهصورت افقی تقسیم میشود.
مثلاً:
اول Database را بساز. بعد Backend. بعد API. بعد Frontend.
مشکل این روش این است که تا زمانی که همه لایهها تمام نشدهاند، چیزی نداریم که واقعاً بتوانیم بهصورت End-to-End تست کنیم.
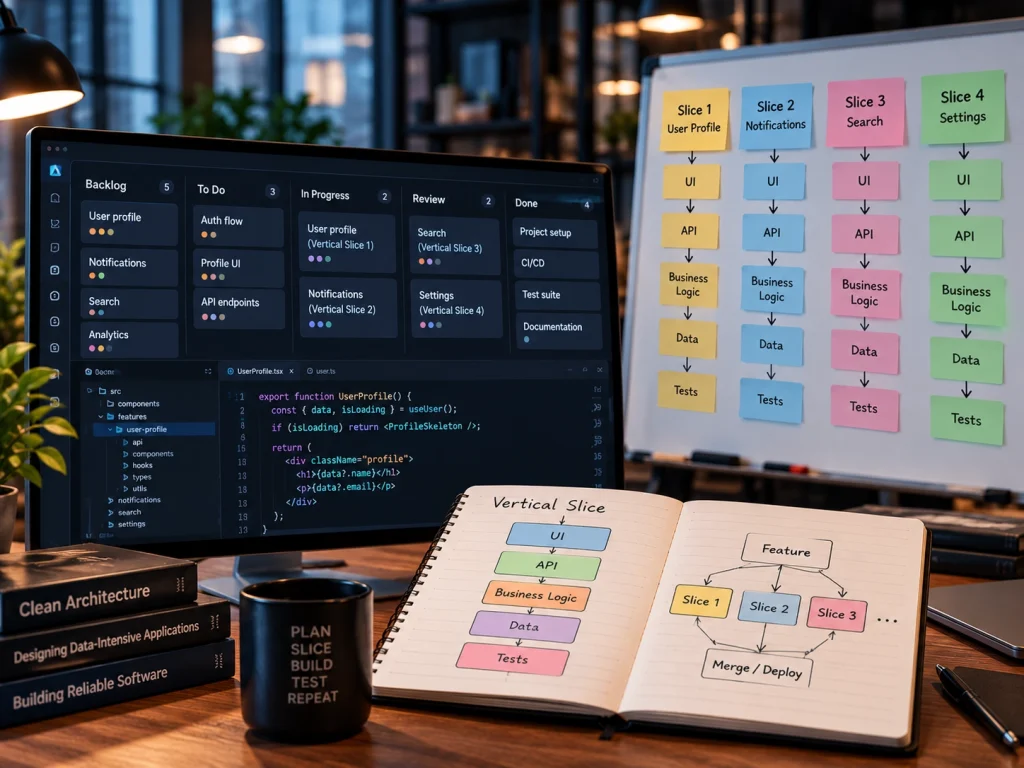
در مقابل، Matt پیشنهاد میکند Feature را به Vertical Sliceهای کوچک تقسیم کنیم.
یعنی هر Slice تا حد امکان یک مسیر کامل از سیستم را پوشش دهد:
Data → Logic → API → UI → Test
این رویکرد با ایده Tracer Bullet هم نزدیکی دارد: ایجاد یک مسیر باریک و قابل آزمایش از میان بخشهای مختلف سیستم برای دریافت بازخورد سریع؛ هرچند این دو اصطلاح دقیقاً یک معنا ندارند. Alexana Learning Library
برای Agentها این روش اهمیت بیشتری پیدا میکند.
چون هر Task:
- کوچکتر میشود؛
- Context کمتری نیاز دارد؛
- مستقلتر است؛
- نتیجهاش سریعتر دیده میشود؛
- و در صورت اشتباه، هزینه اصلاح پایینتر است.
Context Window را باید مثل یک محدودیت مهندسی دید
یکی از بخشهایی که به نظرم خیلی مهم بود، نگاه Matt به Context Window است.
معمولاً وقتی میشنویم مدلی Context بسیار بزرگی دارد، ناخودآگاه تصور میکنیم هرچه اطلاعات بیشتری داخل آن بریزیم بهتر است.
اما در عمل اینطور نیست.
در توضیح این ایده، از دو تعبیر غیررسمی برای کیفیت استفاده از Context صحبت میشود:
Smart Zone و Dumb Zone
ایده این است که هرچه Session طولانیتر، شلوغتر و پر از تاریخچه شود، مدل ممکن است در تصمیمگیریهای مهندسی ضعیفتر شود. داشتن Context بزرگتر الزاماً به این معنی نیست که مدل در تمام طول آن با کیفیت یکسان تصمیم میگیرد. Alexana Learning Library
این موضوع یک نتیجه مهم دارد:
Taskها باید آنقدر کوچک باشند که داخل Context سالم Agent جا شوند.
پس Context Management خودش تبدیل به بخشی از معماری Workflow میشود.
بهجای اینکه یک Agent ساعتها روی یک Conversation ادامه دهد، بهتر است Taskها کوچک، مستقل و قابل Reset باشند.
AI هم Feedback Loop میخواهد
بعد از تعریف Task، تازه بخش Implementation شروع میشود.
اما Agent نباید فقط فایلها را تغییر دهد و بگوید:
«Done.»
Workflow مؤثر باید یک Feedback Loop داشته باشد.
مثلاً:
Task → Test → Implementation → Verification → Commit
Agent یک Issue را انتخاب میکند، تست مینویسد یا تست موجود را اجرا میکند، Implementation را انجام میدهد، نتیجه را بررسی میکند و تنها زمانی Task را تمامشده فرض میکند که یک سیگنال عینی از موفقیت داشته باشد. صفحه بازنشر ویدئو
این نکته بهظاهر ساده است، اما تفاوت بزرگی ایجاد میکند.
اگر Agent فقط بتواند کد بنویسد، عملاً یک مولد متن است.
اما اگر بتواند:
کد بنویسد، تست اجرا کند، Error بگیرد، اصلاح کند، و دوباره تست کند،
آنگاه وارد یک چرخه واقعی مهندسی میشود.
معماری Codebase روی کیفیت Agent اثر مستقیم دارد
یکی از مهمترین برداشتهای من از ویدئو این بود که:
کیفیت محیط و Codebase میتواند بر عملکرد Agent اثر جدی بگذارد.
اگر Codebase پر باشد از:
- فایلهای بسیار بزرگ؛
- Dependencyهای پنهان؛
- Global State؛
- Side Effectهای غیرقابل پیشبینی؛
- Interfaceهای مبهم؛
- و تستهای ضعیف؛
Agent هم در آن دچار مشکل خواهد شد.
اما Codebaseای که Moduleهای کوچک، Boundary مشخص، Interface ساده و Test مناسب داشته باشد، برای Agent بسیار قابل فهمتر است. Alexana Learning Library
جالب اینجاست که دقیقاً همان اصولی که سالها برای انسانها بهعنوان Software Engineering Best Practice توصیه میشدند، حالا برای AI اهمیت بیشتری پیدا کردهاند.
AI اصول مهندسی نرمافزار را حذف نکرده است.
برعکس، در بسیاری از موارد باعث شده اهمیتشان بیشتر دیده شود.
همهچیز را هم نباید به Agent سپرد
در این Workflow، Automation به معنای حذف کامل انسان نیست.
بخش Implementation میتواند تا حد زیادی Autonomous یا AFK شود، اما تصمیمهایی مثل:
- آیا Feature درست تعریف شده؟
- UX خوب است؟
- این خروجی واقعاً همان چیزی است که کاربر میخواهد؟
- معماری پیشنهادی منطقی است؟
- کیفیت نهایی قابل قبول است؟
هنوز به قضاوت انسانی نیاز دارند.
در این نگاه، Planning و QA همچنان به حضور و قضاوت انسان نیاز دارند؛ خودکارسازی کامل ایدهپردازی، تشخیص کیفیت و بازبینی نهایی میتواند ریسک خروجی نامناسب را افزایش دهد. Alexana Learning Library
نقش Developer در حال تغییر است
به نظرم بخش جذاب ماجرا همینجاست.
اگر Agentها بتوانند بخش بزرگی از Implementation را انجام دهند، ارزش Developer دیگر فقط در توانایی نوشتن سریع کد نخواهد بود.
مهارتهای مهمتر احتمالاً اینها خواهند بود:
- تعریف دقیق مسئله؛
- تشخیص ابهامها؛
- طراحی Architecture؛
- تقسیم پروژه به Taskهای درست؛
- طراحی Feedback Loop؛
- مدیریت Context؛
- طراحی تست؛
- و ارزیابی کیفیت خروجی.
یعنی نقش Developer کمکم از کسی که صرفاً کد تولید میکند به کسی تغییر میکند که سیستمی طراحی میکند که بتواند کد باکیفیت تولید کند.
این تفاوت کوچک نیست.
در واقع ممکن است بخش مهمی از مهندسی نرمافزار آینده همین باشد:
Designing the environment in which AI can work well.
چیزی که از این ویدئو با خودم برداشتم
بعد از دیدن این Workflow، به نظرم شاید بیش از حد درباره این سؤال صحبت میکنیم که:
«بهترین مدل برای Coding کدام است؟»
در حالی که سؤال مهمتر میتواند این باشد:
بهترین فرایند برای استفاده از این مدلها چیست؟
مدلها سریع تغییر میکنند.
امروز یک مدل بهتر است، چند ماه دیگر مدل دیگری.
اما اصولی مثل:
تعریف درست مسئله، تقسیم کار، Context Management، Testing، Feedback Loop، Architecture، و Code Review
احتمالاً ماندگارترند.
شاید مزیت واقعی در AI Coding نه از داشتن «بهترین Prompt» و نه حتی «بهترین Model»، بلکه از داشتن بهترین Workflow به دست بیاید.
و این همان چیزی است که این ویدئو بهخوبی نشان میدهد.
تماشای ویدئوی اصلی
Full Walkthrough: Workflow for AI Coding — Matt Pocock صفحه بازنشر ویدئو